Fine-tuning и inference LLM для бизнеса: сколько GPU реально нужно
Компания, решившая дообучить (fine-tune) языковую модель под свои внутренние данные или развернуть собственный inference-сервис вместо обращения к внешнему API, почти сразу упирается в один и тот же вопрос: сколько именно видеокарт для этого реально нужно. Ответ сильно зависит от того, идёт ли речь об обучении модели с нуля, дообучении существующей открытой модели, или просто о запуске готовой модели для генерации ответов — это три принципиально разные по требованиям к оборудованию задачи, и их часто путают ещё на этапе планирования бюджета.
Inference и fine-tuning — разная нагрузка на видеопамять
Запуск уже готовой модели для генерации ответов (inference) требует видеопамяти, примерно пропорциональной размеру модели — большая открытая модель в 70 миллиардов параметров в сжатом (квантизованном) виде помещается в память одной-двух современных профессиональных видеокарт. Дообучение той же модели требует уже в разы больше памяти, поскольку помимо весов модели нужно хранить градиенты и промежуточные состояния оптимизатора — именно поэтому конфигурации для fine-tuning почти всегда строятся вокруг конфигураций с несколькими видеокартами GamingPC, а не одной, даже самой мощной.
Практическая логика подбора количества GPU
- Одна видеокарта. Подходит для inference компактных или средних моделей и для экспериментов с дообучением небольших моделей методом LoRA (когда обучается лишь малая часть параметров, а не вся модель целиком).
- Две видеокарты. Разумный старт для полноценного fine-tuning моделей среднего размера или комфортного inference нескольких пользователей одновременно без длинных очередей запросов.
- Четыре видеокарты и больше. Требуется для дообучения крупных моделей целиком, параллельной обработки большого потока запросов от множества сотрудников одновременно, либо работы сразу с несколькими моделями в производственном режиме.
Почему объединение памяти нескольких GPU — не просто сложение чисел
Важный технический нюанс: суммарная видеопамять нескольких видеокарт не всегда используется так же эффективно, как одна карта с тем же общим объёмом — требуется программная поддержка распределённых вычислений (например, через библиотеки для мульти-GPU обучения) и достаточно быстрая связь между картами внутри одного сервера, чтобы обмен данными между ними не становился узким местом. Именно поэтому серверные конфигурации для ИИ-задач проектируются как единое целое, с учётом внутренней топологии соединений между видеокартами, а не собираются как набор случайных отдельных карт.
Профессиональные ускорители против игровых флагманов для этой задачи
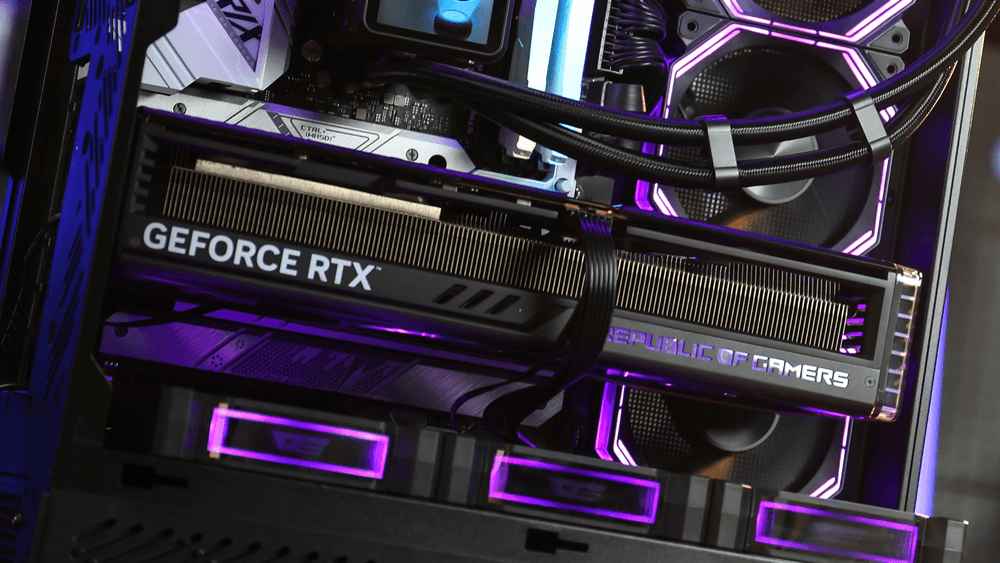
Топовые игровые видеокарты обеспечивают отличную производительность на гигабайт видеопамяти, но профессиональные ускорители с увеличенным объёмом памяти на карту (48 ГБ и выше) позволяют уместить в одном физическом сервере больше суммарной видеопамяти при меньшем количестве карт — что снижает сложность конфигурации и требования к системе охлаждения и питания одновременно. Для бизнес-задач, где сервер работает непрерывно, а не эпизодически, это часто более практичный выбор, чем максимизация чистой вычислительной мощности на карту.
Реальный сценарий: с чего начинают большинство компаний
Типичный путь малого и среднего бизнеса выглядит так: сначала эксперименты с inference готовых открытых моделей на одной-двух видеокартах, чтобы понять, какие задачи внутри компании реально закрывает локальный ИИ (обработка документов, внутренний чат-бот, анализ обращений клиентов). Только после того как конкретная польза подтверждена на практике, имеет смысл инвестировать в более серьёзную конфигурацию под полноценное дообучение модели под специфику компании — это снижает риск переплаты за мощность, которая в итоге не будет использоваться на полную.
Что помимо GPU часто недооценивают в бюджете
Помимо самих видеокарт, конфигурация для по-настоящему серьёзной ИИ-нагрузки требует достаточного объёма оперативной памяти для подготовки и буферизации данных, быстрых NVMe-накопителей для хранения датасетов и весов моделей, а также процессора с достаточным количеством линий PCIe, чтобы не создавать узкое место при передаче данных между несколькими видеокартами одновременно. Экономия именно на этих сопутствующих компонентах — частая причина, по которой дорогая конфигурация с топовыми видеокартами не показывает ожидаемой производительности на практике.
Вывод
Количество видеокарт, необходимое для локального ИИ, определяется не абстрактным «побольше — лучше», а конкретной задачей: inference, LoRA-дообучение малых моделей или полноценное дообучение крупных моделей требуют принципиально разного объёма видеопамяти и разной внутренней архитектуры сервера. Разумная стратегия — начинать с экспериментов на минимально достаточной конфигурации и масштабироваться по мере подтверждения реальной пользы, а не сразу инвестировать в максимальную мощность «про запас».